
Локальная версия DeepSeek V4: как мы спроектировали локальную инфраструктуру для 400 пользователей
-
Тип задачи
Проектирование локальной LLM-инфраструктуры для 400 сотрудников
-
Оборудование
Сервер с 2 × NVIDIA H200 NVL 141 ГБ
-
Условие
Локально, внутри корпоративного контура
-
Режим
Высокая параллельная нагрузка и круглосуточная работа
-
Результат
282 ГБ HBM3e, NVLink и серверное резервирование
Резюме
Команда ServerICT спроектировала локальную инфраструктуру для DeepSeek-V4-Flash с нагрузкой примерно 400 сотрудников. Клиент начал с идеи установить 3 NVIDIA RTX PRO 6000 Blackwell 96 GB. Однако из-за отсутствия NVLink от такой задумки пришлось отказаться. MSI XpertStation WS300 давала высокий запас вычислительных ресурсов, однако не закрывала условия по надежности. Финальной конфигурацией стал сервер с двумя NVIDIA H200: он сочетает высокую пропускную способность HBM3e, связь GPU через NVLink и серверные механизмы резервирования.
Контекст и вводные
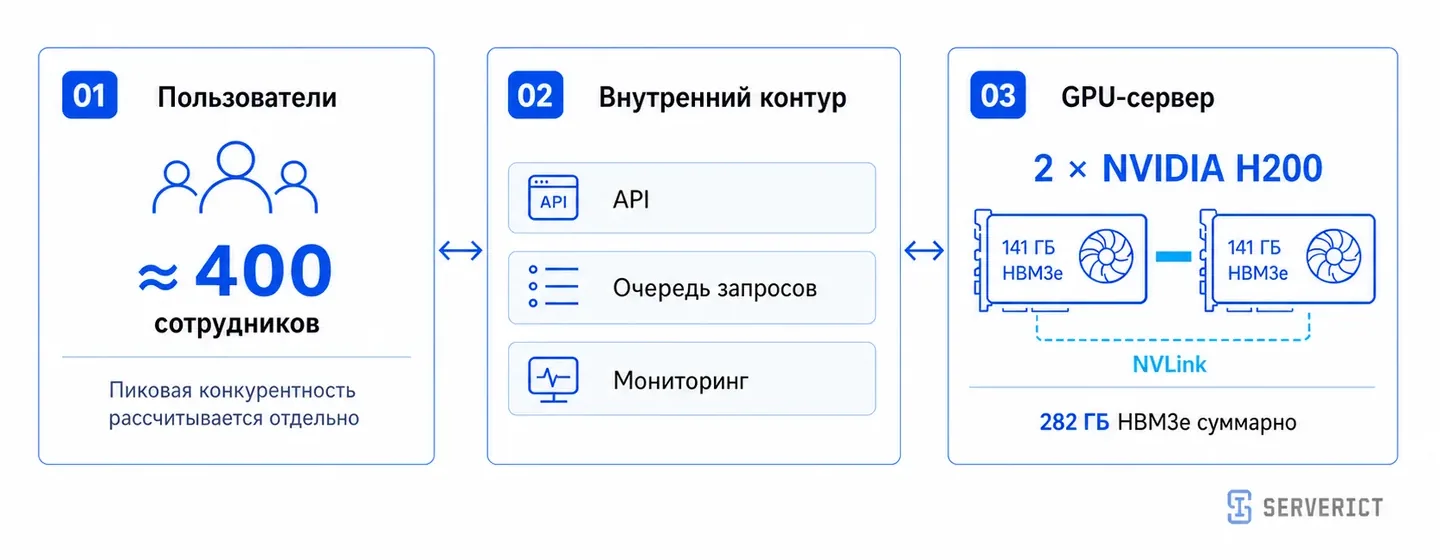
Компания планировала развернуть DeepSeek-V4-Flash во внутреннем контуре и предоставить доступ примерно 400 сотрудникам. Главным требованием была высокая скорость генерации токенов. Сервис должен был сохранять отзывчивость при одновременных запросах и работать круглосуточно, без регулярных остановок на обслуживание или восстановление после сбоев.
Число сотрудников нельзя напрямую переводить в число одновременных сессий: часть пользователей обращается к модели эпизодически, а в часы пик нагрузка может резко расти. При проектировании мы учитывали предполагаемый профиль запросов, длину контекста, размер ответа, параллельную обработку и запас для KV-кеша. Такой расчет показывает реальную потребность в GPU точнее, чем оценка только по размеру весов модели.
Ограничения
-
Нагрузка — примерно 400 сотрудников, но число одновременных сессий определяется отдельно.
-
Сервис должен оставаться отзывчивым при параллельных запросах и работать круглосуточно.
-
Нужно учитывать память движка инференса, рабочие буферы и KV-кеш, а не только веса модели.
-
Требуются стоечное исполнение, резервирование питания и удобное обслуживание.
Системные требования DeepSeek V4 Flash: почему RTX PRO 6000 не хватило для нагрузки
В первоначальном варианте клиент рассматривал NVIDIA RTX PRO 6000 Blackwell с 96 ГБ GDDR7 ECC. В данном проекте ограничение проявилось под расчетной нагрузкой: три карты не обеспечивали нужный темп генерации для большого числа пользователей.
Даже когда весы квантованной модели помещаются в видеопамять, свободное место нужно движку инференса, рабочим буферам и KV-кешу. Последний растет вместе с контекстом и количеством активных последовательностей. При высокой конкурентности приходится уменьшать batch, ограничивать контекст или мириться со снижением скорости на одного пользователя. Поэтому запрос «как запустить DeepSeek локально» начинается с нагрузочного профиля, а не с выбора карты по объему VRAM.
Почему не выбрали MSI XpertStation WS300
Вторым кандидатом была MSI XpertStation WS300, построенная на архитектуре NVIDIA DGX Station. Система использует Grace Blackwell Ultra, располагает 252 ГБ HBM3e на GPU и общим согласованным пулом памяти до 748 ГБ. По запасу памяти и вычислительным возможностям она заметно превосходила исходный вариант с одной RTX PRO 6000.
MSI XpertStation WS300 хорошо подходит для развертывания MVP и локальной работы с ИИ-моделями в офисе. В данном проекте инфраструктуру готовили к промышленной эксплуатации: клиенту требовались стоечное исполнение, резервирование питания и удобное обслуживание оборудования. Под эти условия лучше подошел сервер с двумя ускорителями NVIDIA H200.
Серверная конфигурация также упрощает замену компонентов. Если один из ускорителей H200 выйдет из строя, его можно оперативно заменить как отдельную карту. В WS300 GPU интегрирован в платформу и не рассчитан на такую быструю замену, что усложняет восстановление системы при аппаратной неисправности.
Сравнение конфигураций для локального запуска DeepSeek V4
Таблица показывает пригодность вариантов для конкретной нагрузки. Это не универсальный рейтинг ускорителей: итог зависит от сборки модели, движка инференса, параметров контекста и выбранной серверной платформы.
| Критерий | RTX PRO 6000 Blackwell | MSI XpertStation WS300 | Сервер с 2 × H200 |
|---|---|---|---|
| Память GPU | 96 ГБ GDDR7 ECC | 252 ГБ HBM3e; до 748 ГБ согласованной памяти | 2 × 141 ГБ HBM3e; 282 ГБ суммарно |
| Связь GPU | Три ускорителя в исходной конфигурации | Grace Blackwell Ultra с NVLink-C2C | NVLink между ускорителями |
| Скорость в сценарии клиента | Ниже требуемой | Высокий потенциал, но вариант не прошел по надежности | Соответствует проектному приоритету |
| Надежность | Зависит от платформы; исходный вариант не принят | Единичная станция не закрыла согласованный сценарий | Серверное резервирование блоков питания и компонентов |
Сравнение отражает условия проекта; публичные характеристики приведены по данным производителей.
Решение ServerICT: сервер с двумя NVIDIA H200
После анализа требований мы предложили сервер с двумя NVIDIA H200. Каждый ускоритель оснащен 141 ГБ HBM3e с пропускной способностью 4,8 ТБ/с. Суммарно в системе доступно 282 ГБ GPU-памяти, распределенной между двумя картами. Модель и нагрузку можно разделить средствами движка инференса, используя тензорный параллелизм.
NVLink ускоряет обмен данными между GPU и снижает накладные расходы при совместной обработке модели. При этом NVLink сам по себе не превращает память двух ускорителей в единый адресный пул: корректная работа зависит от поддержки со стороны фреймворка и выбранной схемы параллелизма. Этот момент мы учитываем при подготовке программного стека и тестировании конфигурации.
Серверная платформа также закрывала требования по надежности. В конфигурацию можно заложить резервирование блоков питания и других критичных компонентов, предусмотренных выбранным шасси. Систему проще встроить в существующий контур мониторинга, регламентного обслуживания и восстановления.
Как пользоваться DeepSeek V4 в корпоративном контуре
При корпоративном запуске нужно подготовить модель и весь сервисный контур. Мы последовательно проверяем четыре блока.
- Фиксируем нагрузку: ожидаемое число активных сессий, длину контекста, объем ответа, пиковые часы и допустимое время отклика.
- Проверяем сборку DeepSeek-V4-Flash и совместимость движка инференса с тензорным параллелизмом и нужной длиной контекста.
- Проводим нагрузочное тестирование на сценариях клиента. Измеряем общую пропускную способность, скорость на пользователя, задержку первого токена и поведение системы при росте очереди.
- Настраиваем мониторинг GPU, памяти и очередей, а также правила перезапуска, оповещения и регламент обслуживания.
Конкретное значение токенов в секунду фиксируется после тестов с реальными параметрами запросов. Публиковать расчетную цифру без контекста было бы некорректно: короткий одиночный запрос и сотни параллельных длинных диалогов создают принципиально разную нагрузку.
Результат
Клиент получил инфраструктуру, рассчитанную на высокую скорость генерации токенов и обслуживание примерно 400 сотрудников. Две H200 дали необходимый запас по памяти и пропускной способности, а серверное исполнение упростило организацию круглосуточной эксплуатации.
Конфигурацию выбрали по совокупности требований. RTX PRO 6000 Blackwell 96 GB не выдерживала плановый темп генерации, а MSI XpertStation WS300 не закрывала принятую модель надежности. Сервер с двумя H200 оказался сбалансированным вариантом для производительности, параллельной нагрузки и дальнейшего обслуживания системы.
Итог
- Для 400 сотрудников важен расчет пиковой конкурентности, а не простое сопоставление модели с объемом видеопамяти;
• Одна NVIDIA RTX PRO 6000 Blackwell 96 GB не обеспечила требуемую скорость генерации в проектном сценарии;
- MSI XpertStation WS300 имела высокий запас ресурсов, но не соответствовала требованиям клиента по надежности;
- Сервер с двумя NVIDIA H200 объединил HBM3e, NVLink и возможности серверного резервирования в одной конфигурации.
Похожая ситуация?
Этот кейс интересен, если:
- Планируете развернуть DeepSeek или другую LLM внутри корпоративного контура.
- Нужно рассчитать GPU-инфраструктуру для сотен сотрудников и пиковой конкурентности.
- Выбираете между рабочей станцией и стоечным GPU-сервером.
- Требуются NVLink, высокая пропускная способность памяти и круглосуточная эксплуатация.
- Нужно проверить конфигурацию нагрузочными тестами до запуска.