
Как развернуть DeepSeek V4 Flash локально: MVP на MSI XpertStation WS300
-
Тип задачи
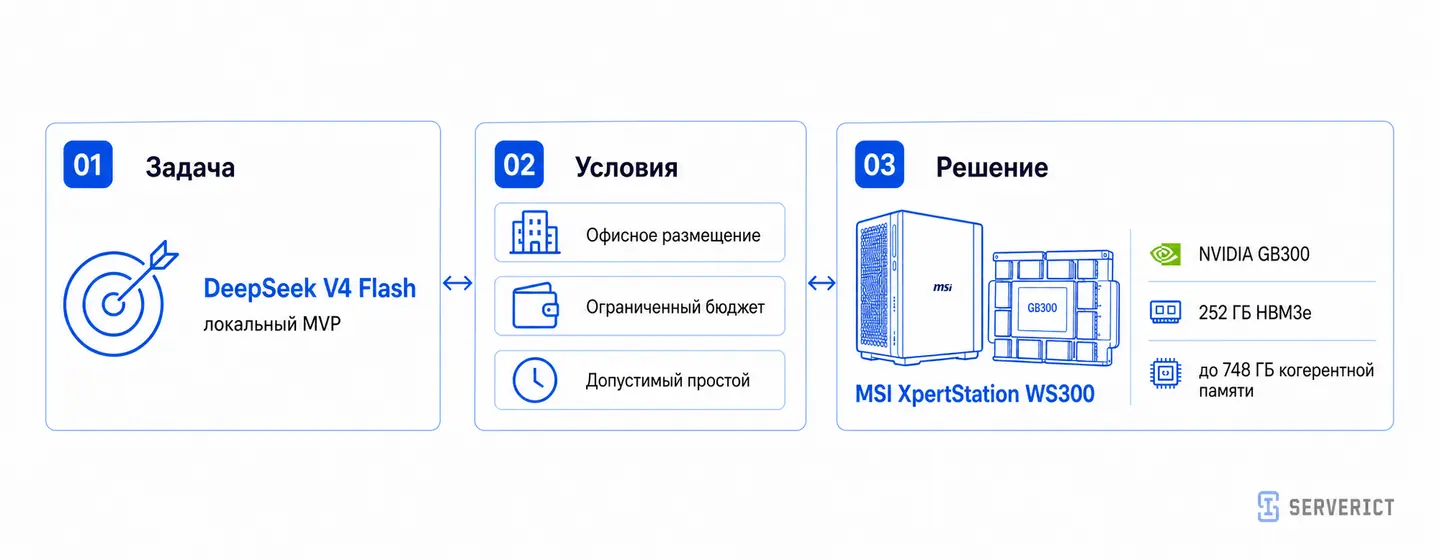
Локальный MVP DeepSeek V4 Flash
-
Оборудование
MSI XpertStation WS300 на NVIDIA GB300
-
Условие
Внутренний контур и офисное размещение
-
Режим
Тестовый контур с приоритетом скорости
-
Результат
252 ГБ HBM3e и до 748 ГБ когерентной памяти
Резюме
В этом кейсе рассказываем, как ServerICT подобрала платформу для тестового запуска DeepSeek V4 Flash. Клиенту была нужна высокая скорость, но HGX-система не укладывалась в бюджет, а оборудование предстояло разместить в офисе. Решением стала MSI XpertStation WS300 на архитектуре NVIDIA DGX Station: модель работает с данными в HBM3e, а когерентный пул памяти оставляет запас для экспериментов с более крупными моделями.
Контекст и вводные
Клиент хотел развернуть DeepSeek V4 Flash во внутреннем контуре и проверить модель на прикладных сценариях. Главным показателем MVP была скорость генерации. Допустимый простой тестовой системы был менее критичен, чем стоимость и производительность решения.
В перспективе клиент хотел перейти к более крупным моделям, в том числе рассмотреть GLM 5.2.
Почему выбрали XpertStation
Для этого проекта требовался офисный MVP с меньшей нагрузкой, допустимым простоем и ограниченным бюджетом. Промышленное резервирование на этапе тестирования не требовалось, поэтому MSI XpertStation WS300 стала рациональным выбором.
Если MVP станет постоянным сервисом для сотрудников или клиентов, архитектуру потребуется пересчитать с учетом допустимого времени простоя, восстановления и необходимости второго узла.
Задача: локальная модель DeepSeek для быстрого MVP
Клиент хотел развернуть DeepSeek V4 Flash во внутреннем контуре и проверить модель на прикладных сценариях. Главным показателем MVP была скорость генерации. Допустимый простой тестовой системы был менее критичен, чем стоимость и производительность решения.
В перспективе клиент хотел перейти к более крупным моделям, в том числе рассмотреть GLM 5.2.
Одна модель — разные требования к инфраструктуре
Ранее мы рассказывали о кейсе, где DeepSeek V4 Flash готовили для постоянной работы корпоративного сервиса примерно на 400 сотрудников. Клиенту требовались стоечное размещение, резервирование питания и возможность быстро заменить ускоритель при неисправности. Под эти условия лучше подошел сервер с двумя NVIDIA H200 141 ГБ и NVLink. В XpertStation WS300 GPU интегрирован в платформу и не заменяется как отдельная карта, поэтому станция осталась вариантом для MVP и офисного размещения. Разницу определяют требования клиента, а не сама модель.
Подробнее о первом решении — в кейсе «Локальная версия DeepSeek V4: как мы спроектировали локальную инфраструктуру для 400 пользователей».
Какие системные требования DeepSeek V4 Flash определили выбор
DeepSeek V4 Flash — модель Mixture-of-Experts: в ней 284 млрд параметров, но для одного токена активируется около 13 млрд. Такой подход снижает вычислительную нагрузку по сравнению с одновременной активацией всех параметров, однако требования к памяти по-прежнему остаются высокими.
Системные требования DeepSeek V4 Flash нельзя свести к размеру весов. В памяти также находятся буферы движка и KV-кеш, объем которого зависит от контекста и числа параллельных запросов. Конфигурацию оценивали по целевому профилю MVP, а не по факту первого успешного запуска.
Почему для MVP важна HBM3e
В выбранной конфигурации веса локальной нейросети DeepSeek V4 Flash размещаются в 252 ГБ HBM3e XpertStation WS300. Пропускная способность памяти достигает 7,1 ТБ/с: GPU быстрее получает веса и промежуточные данные во время генерации.
Запас памяти проверяют вместе с контекстом и числом активных сессий. При росте нагрузки потребуется новый расчет. Поэтому формулировка «модель помещается на один ускоритель» относится к целевому режиму этого MVP, а не ко всем сценариям DeepSeek V4 Flash.
Почему не выбрали HGX-систему
HGX-платформы нужны для нескольких ускорителей, масштабирования и дата-центровой эксплуатации. Для текущего MVP этот запас не окупал более высокую стоимость оборудования, серверной стойки и обслуживания.
Решение ServerICT: MSI XpertStation WS300 на NVIDIA GB300
Основой решения стала MSI XpertStation WS300, построенная на архитектуре NVIDIA DGX Station. Внутри установлен NVIDIA GB300 Grace Blackwell Ultra Desktop Superchip: 72-ядерный процессор Grace и один Blackwell Ultra GPU, соединенные через NVLink-C2C. Станция предлагает до 252 ГБ HBM3e на стороне GPU и до 496 ГБ LPDDR5X на стороне CPU.
Для MVP такая архитектура решила сразу несколько задач. DeepSeek V4 Flash работает с данными в быстрой HBM3e без распределения модели между несколькими отдельными ускорителями. Система остается компактной для офисного размещения, а предустановленная Ubuntu 24.04 LTS с инструментами NVIDIA сокращает объем базовой подготовки программной среды.
Отсутствие резервирования на уровне нескольких вычислительных узлов в этом проекте было осознанным компромиссом. Если MVP станет постоянным сервисом для сотрудников или клиентов, архитектуру потребуется пересмотреть: определить допустимое время простоя, порядок восстановления и необходимость второго узла.
Что означает 748 ГБ когерентной памяти
У XpertStation WS300 память CPU и GPU образует общее когерентное адресное пространство объемом до 748 ГБ. Процессор и ускоритель могут обращаться к данным без обычного для дискретных систем постоянного копирования между двумя изолированными пулами. Это упрощает работу с моделями и наборами данных, которые превышают объем одной HBM3e.
При этом LPDDR5X не становится эквивалентом видеопамяти. Ее пропускная способность — до 396 ГБ/с против 7,1 ТБ/с у HBM3e. Если значительная часть рабочих данных выходит за пределы HBM3e, скорость инференса может снизиться. Поэтому корректнее говорить не о памяти, которая одновременно является RAM и VRAM, а о когерентном пуле с двумя уровнями разной производительности.
Сравнение XpertStation WS300 и HGX-платформы для этого проекта
Таблица отражает логику выбора именно для тестового контура. Она не заменяет подбор конкретной HGX-конфигурации: число GPU, объем HBM и требования к питанию зависят от выбранной платформы.
| Критерий | MSI XpertStation WS300 | HGX-класс |
|---|---|---|
| Задача | Локальная разработка, тестирование и инференс на одном узле | Многопроцессорные нагрузки, масштабирование и дата-центровая эксплуатация |
| Ускорители | Один NVIDIA Blackwell Ultra GPU в составе GB300 | Несколько GPU; состав зависит от выбранной HGX-платформы |
| Память | 252 ГБ HBM3e + 496 ГБ LPDDR5X; до 748 ГБ когерентно | Объем HBM и топология зависят от конфигурации |
| Размещение | Deskside; возможно размещение в офисе после проверки питания, тепла и шума | Серверная стойка и подготовленная инженерная инфраструктура |
| Отказоустойчивость | Один узел; для MVP риск принят клиентом | Можно проектировать резервирование, но оно зависит от всей системы |
| Экономика MVP | Меньше начальных затрат и быстрее ввод в тестовый контур | Выше стоимость оборудования, размещения и эксплуатации |
| Выбор в проекте | Выбрано | Не выбрано на этапе MVP |
Сравнение относится к условиям этого MVP; характеристики HGX зависят от конкретной платформы.
Как поставить и запустить DeepSeek локально
Чтобы развернуть локальную модель DeepSeek, недостаточно скачать файлы модели и запустить демонстрационный интерфейс. Для воспроизводимого MVP команда последовательно готовит аппаратную и программную части.
- Фиксирует сценарии тестирования: тип запросов, длину контекста и ожидаемый объем ответа. Проверяет лицензию, контрольные суммы файлов модели и совместимость с актуальной версией vLLM или SGLang.
- Разворачивает среду в контейнере, настраивает локальный API, доступ пользователей и журналирование без передачи корпоративных данных во внешнее облако.
- Проводит нагрузочный тест и измеряет скорость генерации, задержку первого токена, потребление HBM3e и поведение KV-кеша при росте контекста.
- Фиксирует рабочую конфигурацию, ограничения MVP и условия, при которых потребуется расширение или переход на серверную платформу.
Такой порядок отвечает на вопрос, как поставить и запустить DeepSeek локально, без ложного ощущения готовности после первого успешного запроса. Рабочим результатом считается система, которая стабильно воспроизводит целевые показатели на данных и сценариях клиента.
Что проверить перед размещением AI-станции в офисе
Формат deskside означает, что XpertStation можно установить рядом с рабочей зоной, однако это не обычный офисный компьютер. В спецификации указан блок питания 1600 Вт и жидкостное охлаждение. До установки нужно проверить электрическую линию, отвод тепла, фактический уровень шума, физическую защиту и доступ к сети.
Отдельно проектируют хранение весов и данных, резервное копирование конфигурации, мониторинг температуры и загрузки, а также удаленное управление. У WS300 предусмотрены BMC и интерфейсы IPMI 2.0/Redfish, но регламент реагирования на сбой все равно должен быть назначен конкретной команде.
Результат
Клиент получил компактное локальное решение, ориентированное на высокую скорость DeepSeek V4 Flash и соответствующее бюджету MVP. Станцию можно разместить в офисе, а данные и запросы остаются во внутреннем контуре. Отказ от HGX снизил стоимость входа без оплаты неиспользуемых ресурсов.
Архитектура также оставляет пространство для дальнейших экспериментов. Когерентный пул до 748 ГБ расширяет диапазон моделей, которые можно загрузить локально. Для перехода на GLM 5.2 или другую крупную модель потребуется отдельно проверить совместимость с выбранным движком и скорость на нужном контексте. Сам объем памяти не гарантирует требуемую производительность.
Ключевые тезисы кейса
- Для MVP важнее соответствие текущей нагрузке, чем максимальное число GPU в конфигурации;
- MSI XpertStation WS300 объединила 252 ГБ HBM3e, офисный формат и приемлемую для проекта стоимость;
- Когерентные 748 ГБ расширяют возможности станции, но LPDDR5X не заменяет HBM3e по скорости;
- Переход к GLM 5.2 и промышленной эксплуатации требует новых тестов, оценки отказоустойчивости и повторного расчета инфраструктуры.
Похожая ситуация?
Этот кейс интересен, если:
- Нужно развернуть DeepSeek или другую LLM во внутреннем контуре для тестового MVP.
- Выбираете между офисной AI-станцией и серверной HGX-платформой.
- Важно сопоставить объем HBM3e, когерентную память и реальный профиль нагрузки.
- Требуется проверить питание, охлаждение, шум и удаленное управление до размещения системы в офисе.
- Планируете заранее определить условия перехода от MVP к промышленной эксплуатации.